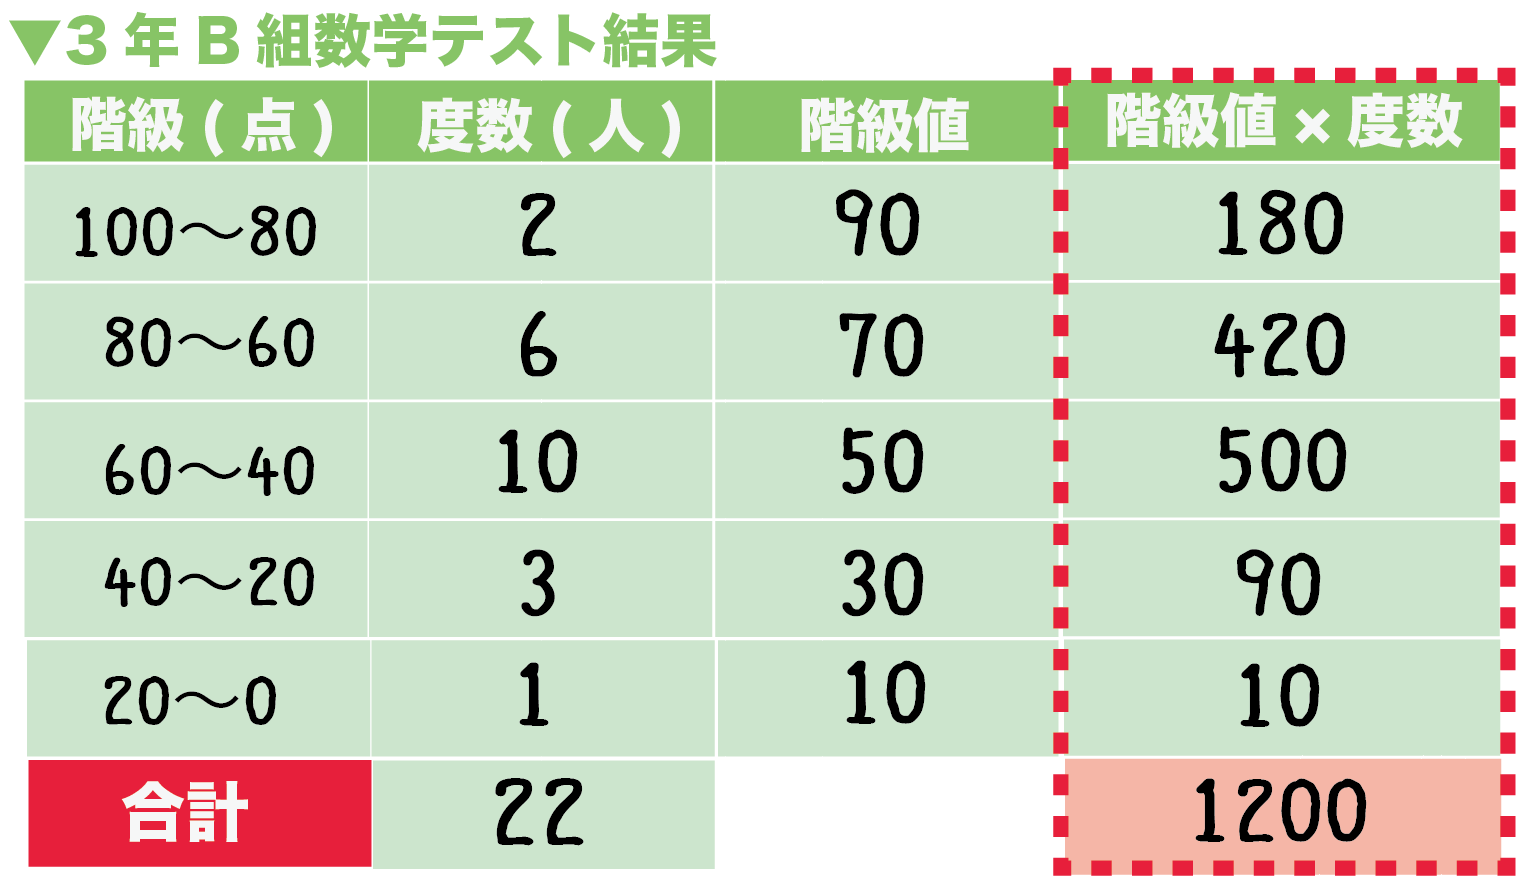
学校の数学テストやビジネスの売上・顧客データ分析で、大量の数値を整理した「度数分布表」から平均値を算出する場面に出くわす人は少なくありません。しかし、手元にあるのはグループ化された数値と件数だけで、個別の元データが分からない状態に戸惑う声も多く聞かれます。 「なぜ個別の生データがないのに平均値が出せるのか」「教科書通りの計算で出した数値は、本当の平均値と一致しているのか」という疑問は、統計学の初歩でありながら極めて本質的な問いです。公式の機械的な丸暗記を脱し、階級値の意味や真の平均値と乖離する構造的なメカニズム、さらには実務で劇的な時短を可能にする仮平均やエクセル活用術まで、その全貌を解き明かします。 📌 【この記事の重要ポイントまとめ】
- 要点1:度数分布表の平均値は「(階級値×度数)の合計÷総度数」で算出し、各データの代表として階級の中央値を用いる。
- 要点2:生データの平均値とズレる決定的な理由は、階級内の散らばりを無視して「全員が階級値を取った」とみなす情報落ちにある。
- 要点3:手計算のミスを防ぐ「仮平均の裏技」やエクセルのSUMPRODUCT関数をマスターすれば、実務や試験での処理速度が劇的に向上する。
【基本手順】度数分布表の平均値はどう求める?階級値の計算公式
度数分布表から平均値を導き出すプロセスは、一見複雑に見えて実は極めて明快な3つのステップで構成されています。生データが手元にない以上、最初に行うべきは「各グループの真ん中の値」を特定する作業です。 まず押さえるべきは、各階級を代表する数値である階級値の求め方です。階級値は、区切られた区間の両端(上限値と下限値)を足して2で割ることで算出します。たとえば「20分以上30分未満」という階級であれば、(20+30)÷ 2 = 25分がその階級値となります。この階級を形作る幅、すなわち30−20=10分を階級の幅と度数(その区間に含まれるデータの個数・人数)として正確に把握することが計算の出発点です。 階級値が求まったら、次は度数分布表の平均値公式に当てはめます。考え方は単純で、「その階級にいる全員が、代表値である階級値と同じ値を持っている」と仮定し、階級ごとの合計値を積み上げていくアプローチを取ります。
【度数分布表における平均値の基本公式】
平均値 = 各階級の(階級値 × 度数)の総和 ÷ 度数の合計(データの総数)
具体的な手順は次の通りです。 1. 各階級の「階級値」をすべて算出する。 2. それぞれの階級について「階級値 × 度数」を計算し、階級ごとの小計を出す。 3. 全階級の「階級値 × 度数」をすべて足し合わせ、全体の合計値を算出する。 4. その合計値を、全体のサンプル数である「総度数」で割る。 この手順さえ守れば、どれほどデータ数が多くても確実に平均値を割り出すことが可能です。
なぜ本当の平均値とズレるのか?現場が直面する「情報落ち」の正体
多くの学習者やデータ分析の現場担当者が一度は抱く強い違和感があります。「元のデータを1つずつ足して割った正真正銘の平均値」と、「度数分布表から求めた平均値」を比べると、往々にして端数やわずかな数値の食い違いが発生する点です。 この度数分布表 平均値 ズレる理由は、統計学における「情報落ち(データの解像度の低下)」という構造に起因します。 生データから度数分布表を作成する際、個別の具体的な数値はすべて「特定の階級に属する1カウント」へと抽象化されます。たとえば「50点以上60点未満」という階級に度数が4人いた場合、階級値は55点として計算されます。しかし、実際の4人の点数は「51点、51点、52点、53点」と下限寄りに偏っていたかもしれません。あるいは「58点、59点、59点、59点」と上限付近に固まっていた可能性もあります。 度数分布表の計算モデルでは、内部の偏りを一切考慮せず「55点が4人いる」と強引に均一化して処理します。そのため、階級内での実データの偏りが相殺されずに残った分だけ、真の平均値との間に不可避のギャップが生じるわけです。 ヒストグラム 平均値の歪みを可視化すると、左右非対称なロングテールの分布や少数の外れ値が存在するデータセットほど、この乖離幅が広がりやすい性質を持っています。度数分布表から導く平均値は、あくまで「全体像を把握するために解像度を落とした近似値(推定値)」であるという本質を忘れてはなりません。

